はじめに
前回は、Relative Band Distanceについて、
A:0.44 ~ 0.88
B:0.44 ~ 1.00
C:0.50 ~ 1.00
D:0.60 ~ 1.00
という4つの候補を、時間軸で比較しました。
全期間のProfit Factorだけを見ると、
A:1.397
B:1.639
C:1.708
D:1.861
となり、
D:0.60 ~ 1.00
が圧倒的に強く見えます。
しかし、時間を4分割すると、
A
1.280 → 1.440 → 1.458 → 1.458

D
2.554 → 2.041 → 1.646 → 1.091
という大きな違いがありました。
AはPFこそ低いものの非常に安定しています。
一方、Dは過去ほど強く、最近になるほど成績が低下しています。
そこで前回は、
A:安定性重視
C:収益性と安定性のバランス型
D:高収益だが過去依存の疑いが強い
と整理しました。
ただ、ここまでの分析には一つ大きな問題があります。
それは、
実際に運用したとき、どれくらい資産が減るのか
をまだ見ていないことです。
今回は4条件に加えて、
フィルターなし
も含めた5条件について資産曲線を作り、
Relative Band Distanceフィルターを入れることで、本当に「運用しやすいシステム」になるのか
を調べます。
PFだけでは運用の苦しさは分からない
これまで条件を評価するときには、主に、
Profit Factor
総損益
平均損益
勝率
などを使ってきました。
もちろん、これらは重要です。
しかし実際にシステムを運用することを考えると、もう一つ無視できない数字があります。
それが、
Drawdown
です。
例えば、
システム①
PF 1.50
最大DD 10%

システム②
PF 1.80
最大DD 40%
だったとします。
PFだけなら②の方が優秀です。
しかし、実際に自分のお金を投入するとなれば話は変わります。
100万円から運用を開始して、
100万円
↓
60万円
まで一時的に減るシステムを、本当に使い続けられるのか。
バックテスト結果を知っていたとしても、実運用中には、
これは想定内のDDなのか

それとも

システムの優位性が消えたのか
を判断できません。
だからこそ、
どれだけ稼いだか
だけではなく、
その利益を得るまでに、どれだけ耐える必要があったか
を見る必要があります。
今回は「フィルターなし」も比較する
今回比較するのは5条件です。
BASE:フィルターなし

A:0.44 ~ 0.88

B:0.44 ~ 1.00

C:0.50 ~ 1.00

D:0.60 ~ 1.00
これまでA~Dを比較してきましたが、今回はBASEを追加します。
理由は単純です。
Relative Band Distanceを零号機へ実装するということは、
条件に合わない取引を捨てる
ということだからです。
例えば、Cを採用すれば、
0.50 <= Relative Band Distance <= 1.00
の取引しか残りません。
確かにPFが上昇したとしても、その代わり大量の利益トレードまで捨てている可能性があります。
そこで、
元の零号機
↓
フィルターを追加
↓
何が改善し、何を失ったのか
を確認します。
今回見る指標
各条件について、次の数字を計算します。
取引数
勝率
総損益
平均損益
Profit Factor

最終資産
最大ドローダウン額
最大ドローダウン率
特に重要なのが、
最大ドローダウン率
です。
今回は同じ初期資金からスタートさせることで、
どの条件が最も効率よく利益を積み上げられたのか
を比較します。
資産曲線を作る
まず、それぞれの条件について取引を時系列順に並べます。
そして、
初期資金
+
累積損益
を計算します。
最終利益が同じでも、
右肩上がりに比較的滑らかに増えたシステム
と、
何度も大きく落ちながら最後に利益が残ったシステム
では、運用のしやすさは大きく違います。
ドローダウンとは何か
ドローダウンは、
過去の資産最高値から、どれだけ資産が減ったか
を表します。
例えば、
70万円
↓
80万円
↓
100万円
↓
85万円
↓
110万円
という資産推移だった場合、
100万円から85万円まで落ちた部分がドローダウンです。
最大DD額

100万円 - 85万円
= 15万円
最大DD率は、
15万円 ÷ 100万円
= 15%
です。
つまり、
最大DD額:150,000円
最大DD率:15%
となります。
「初期資金に対する損失率」ではない
ここは重要です。
最大DD率は、
最大DD額 ÷ 初期資金
ではありません。
その時点までに到達した、
資産の最高値
を基準にします。
例えば70万円からスタートして、
70万円
↓
100万円
↓
80万円
となった場合、
初期資金から見ればまだ、
+10万円
です。
しかし、実際には100万円から80万円まで20万円減っています。
したがって、
最大DD率 = 20万円 ÷ 100万円
          = 20%
となります。
実際に運用するときに感じるリスクに近いのはこちらです。
Relative Band DistanceはDDを減らせるのか
今回もっとも知りたいのはここです。
Relative Band DistanceフィルターによってPFが上昇した理由が、
負けやすい取引を効率よく排除したから
なのであれば、ドローダウンも改善する可能性があります。
理想的には、
BASE

PF          1.35
最大DD率    25%

↓

C

PF          1.71
最大DD率    15%
のようになります。
こうなれば、
収益性 ↑
リスク ↓
なので、フィルターを採用する理由はかなり強くなります。
一方、
BASE

PF          1.35
最大DD率    15%

↓

D

PF          1.86
最大DD率    35%
となった場合は話が違います。
PFは上がっていても、
利益と引き換えに運用リスクまで大きくしている
ことになります。
AとCの比較が特に重要
前回の結果から、今回もっとも注目したいのは、
A:0.44 ~ 0.88

C:0.50 ~ 1.00
です。
Aは、
全期間PF:1.397
最低期間PF:1.280
PF標準偏差:0.075
と、時間安定性が非常に高い条件でした。
一方Cは、
全期間PF:1.708
最低期間PF:1.274
PF標準偏差:0.337
でした。
面白いのは、
最低期間PF

A:1.280
C:1.274
とほとんど変わらないにもかかわらず、
全期間PF

A:1.397
C:1.708
まで差が開いていることです。
もし今回、
Cの最大DD ≒ Aの最大DD
あるいは、
Cの最大DD < Aの最大DD
となれば、
CはAと同程度の下振れ耐性を持ちながら、より高い収益性を持つ
可能性があります。
そうなればCはかなり有力な候補になります。
Dは本当に「高リスク・高リターン」なのか
もう一つ注目するのがDです。
D:0.60 ~ 1.00
は全期間PF、
1.861
で4条件中トップでした。
しかし前回、
Period1:2.554
Period2:2.041
Period3:1.646
Period4:1.091
と、時間とともにPFが低下していることが分かりました。
さらに、
前半:2.368
後半:1.370
でした。
つまりDには、
昔の非常に強い成績によって全期間PFが押し上げられている
疑いがあります。
では資産曲線はどうなるのか。
もし、
高PF
+
大きなDD
+
後半の資産曲線が横ばい
となれば、
Dを零号機へ採用する理由はかなり弱くなります。
反対に、
高PF
+
小さなDD
+
資産曲線も比較的滑らか
なら、前回の時間安定性の問題があったとしても再評価する必要があります。
最大DDだけでなく資産曲線そのものを見る
今回は最大DDという一つの数字だけではなく、
資産曲線そのもの
も確認します。
例えば、
最大DD 15%
というシステムが2つあっても、
一方は12年間で一度だけ15%下落し、それ以外は比較的安定しているかもしれません。
もう一方は、
10%
12%
15%
11%
14%
と何度も大きなDDを経験しているかもしれません。
最大DDだけでは、この違いは分かりません。
そこで、
equity_curve_comparison.png
として5条件の資産曲線を重ねて表示します。
ドローダウン曲線も作る
さらに、
drawdown_curve_comparison.png
も作ります。
各時点について、
現在資産
-
それまでの最高資産
を計算します。
最高値なら、
DD = 0
です。
そこから資産が減るほど、
-5%
-10%
-15%
と下方向へ伸びます。
これによって、
どの条件が、いつ、どの程度苦しい時期を経験したのか
を視覚的に比較できます。
最大DDが起きた時期も調べる
今回は最大DDの大きさだけではなく、
DD開始時点
DD底値
も記録します。
例えば、
最大DD率:18.4%

Peak:
2022-03-10

Bottom:
2022-09-21
のような形です。
これによって、
各条件が同じ相場環境で崩れているのか
を見ることができます。
もしA~Dがすべて同じ時期に大きく落ちているのであれば、
Relative Band Distanceとは別の要因によって零号機そのものが苦手な相場だった可能性があります。
逆に、
BASEは大きく下落
Cは比較的耐える
という時期があれば、
Relative Band Distanceフィルターが実際にリスクを抑えている可能性があります。
回復までに何取引かかったかも見る
最大DDからどれだけ早く回復したかも重要です。
そこで今回は、
最大DDのピーク
↓
DDの底
↓
再び過去最高資産を更新
までの取引数も計算します。
例えば、
最大DD率:15%

回復まで:25取引
と、
最大DD率:15%

回復まで:180取引
では、同じ15%でも意味がかなり違います。
実運用では、
どれくらい長く「負けている状態」に耐えなければならないのか
も重要だからです。
今回の評価軸
最終的には、単純に、
PFが一番高い条件
を選ぶのではなく、
収益性 × ドローダウン × 時間安定性
の3つで考えます。
理想は、
PFが高い
↓
最大DDが小さい
↓
資産曲線が滑らか
↓
過去だけでなく最近も機能している
条件です。
これまでの分析では、
収益性
時間安定性
までは見てきました。
今回、
リスク
を追加することで、Relative Band Distanceについてかなり立体的に評価できるようになります。
出力されるファイル
今回のコードでは、次の6ファイルを出力します。
equity_drawdown_summary.csv
equity_curve_data.csv
drawdown_curve_data.csv

equity_curve_comparison.png
drawdown_curve_comparison.png
max_drawdown_comparison.png
特に重要なのは、
equity_drawdown_summary.csv
です。
ここには各条件について、
取引数
勝率
総損益
平均損益
PF
最終資産
最大DD額
最大DD率
DD開始時点
DD底値
回復時点
回復までの取引数
がまとまります。
また、
equity_curve_comparison.png
では、
BASE
A
B
C
D
の5本の資産曲線を直接比較します。
これまで数字として見てきたRelative Band Distanceの違いが、
実際の資産推移としてどの程度の差になるのか
を確認できます。
分析結果
結果はかなり興味深いものになりました。
まず5条件の主要な結果を整理します。
| 条件 | 取引数 | PF | 総損益 | 1取引平均 | 最大DD率 |
|---|---|---|---|---|---|
| BASE | 1,725 | 1.321 | 213,290円 | 124円 | 3.736% |
| A:0.44~0.88 | 441 | 1.397 | 60,876円 | 138円 | 2.257% |
| B:0.44~1.00 | 534 | 1.639 | 117,305円 | 220円 | 1.611% |
| C:0.50~1.00 | 452 | 1.708 | 108,243円 | 239円 | 1.639% |
| D:0.60~1.00 | 344 | 1.861 | 94,287円 | 274円 | 1.122% |
まず明確なのは、
Relative Band Distanceフィルターには、PFを高めるだけでなく、ドローダウンを抑える効果も確認できた
ということです。
フィルターなしのBASEでは最大DD率が、
3.736%
だったのに対して、A~Dではすべて、
1.122% ~ 2.257%
まで低下しました。
つまりRelative Band Distanceは単に「利益の出やすい取引を選別している」だけではありません。
大きなドローダウンにつながる取引もかなり排除できていることが分かります。
BASEは最も利益が大きい。しかし効率は低い
まずBASEを見ると、
取引数:1,725
総損益:213,290円
PF:1.321
最大DD率:3.736%
でした。
総損益だけなら5条件の中で圧倒的な1位です。
資産曲線も、
70万円
↓
約91.3万円
まで増加しています。
しかし、これは当然でもあります。
BASEは1,725回取引しているのに対して、
A:441回
B:534回
C:452回
D:344回
しか取引していないからです。
重要なのは、1取引あたりの利益です。
BASE:124円
A:138円
B:220円
C:239円
D:274円
Relative Band Distanceの下限を上げるほど、平均損益が大きく改善しています。
BASEとDを比較すると、
BASE:124円
D:274円
なので、DはBASEの約2.2倍です。
つまりRelative Band Distanceによって、
取引回数を減らす代わりに、質の高い取引へ集中する
というフィルター本来の効果が、かなり明確に出ています。
最大DDはDが最小だった
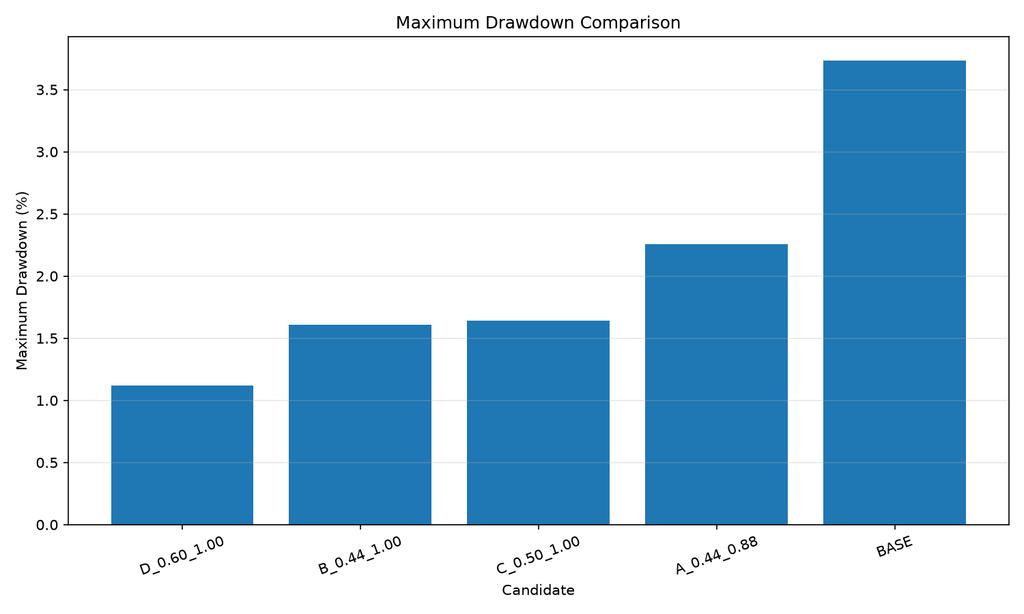
今回もっとも意外だったのがここです。
最大DD率を小さい順に並べると、
D:1.122%
B:1.611%
C:1.639%
A:2.257%
BASE:3.736%
となりました。
前回までの分析では、
A=安定型

C=バランス型

D=高PFだが時間依存性に懸念
と考えていました。
そのため、資産曲線についても、
A → DDが小さい
D → DDが大きい
という結果になる可能性を想定していました。
しかし、実際には完全に逆でした。
Dが最大DD最小です。
しかも、
BASE:3.736%
D:1.122%
なので、BASEと比較すると最大DD率は約70%低下しています。
PFについても、
BASE:1.321
D:1.861
です。
したがってDは、
PF   上昇
平均損益 上昇
最大DD  低下
を同時に達成しています。
これは非常に強い結果です。
PFは総利益÷総損失、最大DDは資産曲線の過去最高値からの最大下落を表すため、本来は別の側面を測る指標です。両方が同時に改善していることには意味があります。
「フィルターを厳しくするほどリスクが増える」わけではなかった
今回の結果を並べると、さらに面白いことが分かります。
BASE
PF 1.321
DD 3.736%

A
PF 1.397
DD 2.257%

B
PF 1.639
DD 1.611%

C
PF 1.708
DD 1.639%

D
PF 1.861
DD 1.122%
細かく見るとBとCではわずかに逆転していますが、全体としては、
Relative Band Distanceの条件を厳しくするほどPFが上昇し、最大DDが低下する
傾向が見えます。
これはかなり重要です。
もしフィルターが単なる過剰最適化であれば、
PFは上がった

しかし

取引数減少によって資産曲線が不安定になった
という結果も考えられます。
ところが今回、少なくとも全期間のバックテストでは逆でした。
取引を絞った方が資産曲線の最大下落まで小さくなっています。
Relative Band Distanceが、零号機にとって意味のある市場状態を捉えている可能性がさらに高まりました。
Aの評価は下げる必要がありそう
今回の結果で、Aについては評価を少し見直す必要があります。
前回、Aは期間別PFが、
1.280
1.440
1.458
1.458
と非常に安定していました。
そのため、
最も堅牢な条件なのではないか
と考えていました。
しかし今回、
最大DD率:2.257%
となり、A~Dでは最大でした。
さらに総損益も、
60,876円
で4候補中最低です。
平均損益も、
138円
にとどまります。
つまりAは、
PFの時間安定性は非常に高いが、資金効率やDDまで含めると必ずしも最も優秀ではない
という位置づけになりました。
これは今回DDを調べたからこそ分かったことです。
「期間別PFが安定していること」と「資産曲線が安定していること」は、同じではありません。
CよりBの方がDDはわずかに小さい
BとCは非常に似ています。
B
PF:1.639
最大DD:1.611%
総損益:117,305円
平均損益:220円

C
PF:1.708
最大DD:1.639%
総損益:108,243円
平均損益:239円
最大DDについては、
B:1.611%
C:1.639%
で、ほぼ同じです。
差はわずか、
0.028ポイント
です。
その一方でCは、
PF:1.708
平均損益:239円
とBを上回っています。
Bは取引数が多いため総損益ではCを上回っていますが、
1回の取引をどれだけ効率よく選別できているか
という観点ではCが一歩上です。
したがって、前回Cを「バランス型」と評価したことについては、今回の結果でも大きく崩れていません。
ただし、Dの評価が大きく変わった
今回最も評価が変わったのはDです。
Dは、
取引数:344
PF:1.861
平均損益:274円
最大DD:1.122%
でした。
4候補の中で、
PF     1位
平均損益  1位
最大DD   1位
です。
これだけを見ると、Dが圧倒的です。
しかし、ここで前回の分析が重要になります。
Dの期間別PFは、
Period1:2.554
Period2:2.041
Period3:1.646
Period4:1.091
でした。
つまり、
全期間では最も優秀だが、時間とともに優位性が弱くなっている
という問題は依然として残っています。
今回の結果によってDの弱点が消えたわけではありません。
むしろDについて、
収益性 ◎
資金効率 ◎
DD   ◎
時間安定性 △
という特徴が、よりはっきりしました。
これは非常に興味深いです。
Dは「高リスク・高リターン」ではなかった
第24回を始める前は、
D
高PF
↓
高リスク・高リターン?
という可能性も考えていました。
しかし今回、その仮説は否定されました。
少なくともこのバックテストでは、
Dは高リスク・高リターンなのではなく、高収益・低DDである
という結果です。
問題はリスク量ではありません。
問題なのは、
その優位性が時間とともに失われている可能性
です。
ここは区別して考える必要があります。
Dは「危険だから採用しにくい」のではありません。
過去の非常に強い成績が、現在でも再現できるのか分からないから採用しにくい。
ということです。
ドローダウンの「長さ」にも大きな違いがあった
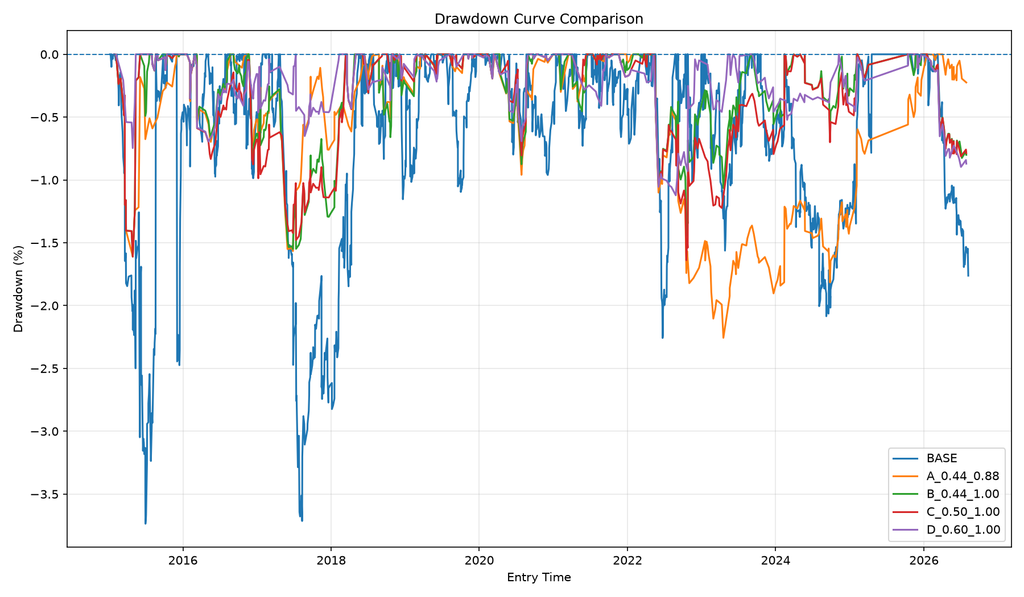
最大DDから回復するまでの取引数を見ると、
BASE:68取引
A:130取引
B:15取引
C:72取引
D:32取引
でした。
ここでもAの弱さが目立ちます。
Aの最大DDは、
2022年5月
↓
2023年4月
に底をつけましたが、そこから過去最高資産を回復したのは、
2026年1月
です。
つまりAは最大DD率自体は2.26%程度ですが、
一度崩れると最高値を更新するまで非常に長い
という特徴があります。
一方Dは、
最大DD:1.122%
回復まで:32取引
でした。
Bに至っては、
最大DD:1.611%
回復まで:15取引
です。
単純なDD率だけでなく、
ドローダウンからどれくらい早く戻れるか
という観点でも、B・Dは優秀でした。
資産曲線を見ると別の問題も見える
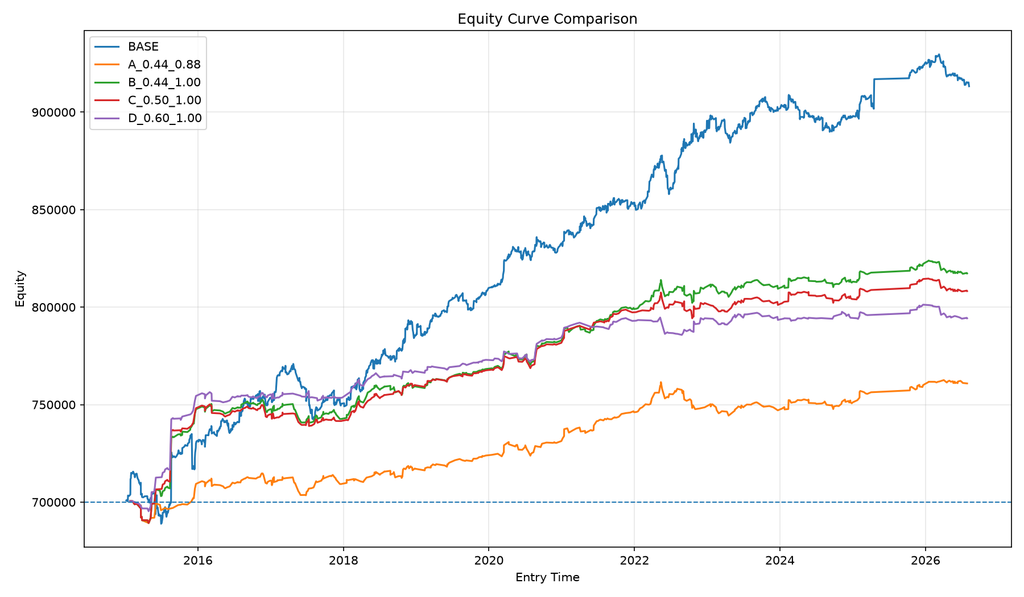
一方で、資産曲線を見ると非常に重要な特徴があります。
2015年から2022年頃までは、
B
C
D
はいずれも比較的きれいに右肩上がりです。
しかし2022年以降を見ると、その傾きが明らかに弱くなっています。
特にDは、
2022年頃:約79万円
↓
2026年:約79~80万円
と、長期間ほぼ横ばいです。
これは前回の期間別PF分析と一致します。
つまり、
期間別PFの低下
という数字だけではなく、
資産曲線の傾き
としてもDの優位性低下が見えています。
ここは今回の最大DD1.122%という好結果だけを見てはいけないポイントです。
Dは最近大きく負けてはいません。
しかし、
最近は大きく稼げてもいない
のです。
現時点ではCが依然として有力
ここまでを整理すると、
A
時間安定性 ◎
収益性   △
DD     △

B
時間安定性 ○
収益性   ○
DD     ◎

C
時間安定性 ○
収益性   ◎
DD     ◎

D
時間安定性 △
収益性   ◎◎
DD     ◎◎
という評価になります。
今回だけを見るならDです。
しかし第23回の時間分析まで含めると、Dをそのまま採用するのはまだ怖い。
一方Cは、
PF:1.708
平均損益:239円
最大DD:1.639%
と十分強く、Dほど極端な時間劣化もありません。
したがって現時点では、
C(0.50~1.00)が最もバランスの取れた候補
という評価を維持したいと思います。
ただし今回の結果によって、
Dを捨てるには惜しすぎる
という新しい問題も出てきました。
今回分かったこと
今回の分析で、Relative Band Distanceについてかなり重要なことが分かりました。
① フィルターによってPFが改善する

② 平均損益も改善する

③ 最大DDも大幅に低下する

④ 特にDはPF・平均損益・最大DDすべてで最良

⑤ ただしDには時間劣化という別の問題がある

⑥ Aは時間安定性は高いが、資産効率では弱い

⑦ 現時点ではCが最もバランス型
Relative Band Distanceは、単なる「PF改善用フィルター」ではなさそうです。
むしろ、
零号機が優位性を発揮しやすい相場状態を切り出す変数
である可能性がかなり高まってきました。
一方で今回、もう一つ新しい疑問が生まれました。
それは、
なぜDは2015~2021年頃には非常に強かったのに、2022年以降はほとんど資産を伸ばせなくなったのか
です。
ここを解明しないままDを採用するのは危険です。
今回のコード
ファイル名は、
relative_band_equity_drawdown.py
とします。
コード全文
import os
import numpy as np
import pandas as pd
import matplotlib.pyplot as plt


# ============================================================
# 設定
# ============================================================

INPUT_FILE = "results/trade_base.csv"
OUTPUT_DIR = "results"

os.makedirs(
    OUTPUT_DIR,
    exist_ok=True
)

INITIAL_CAPITAL = 700000


CANDIDATES = {
    "BASE": None,
    "A_0.44_0.88": (0.44, 0.88),
    "B_0.44_1.00": (0.44, 1.00),
    "C_0.50_1.00": (0.50, 1.00),
    "D_0.60_1.00": (0.60, 1.00),
}


# ============================================================
# 出力ファイル
# ============================================================

SUMMARY_CSV = os.path.join(
    OUTPUT_DIR,
    "equity_drawdown_summary.csv"
)

EQUITY_CSV = os.path.join(
    OUTPUT_DIR,
    "equity_curve_data.csv"
)

DRAWDOWN_CSV = os.path.join(
    OUTPUT_DIR,
    "drawdown_curve_data.csv"
)

EQUITY_GRAPH = os.path.join(
    OUTPUT_DIR,
    "equity_curve_comparison.png"
)

DRAWDOWN_GRAPH = os.path.join(
    OUTPUT_DIR,
    "drawdown_curve_comparison.png"
)

MAX_DD_GRAPH = os.path.join(
    OUTPUT_DIR,
    "max_drawdown_comparison.png"
)


# ============================================================
# データ読み込み
# ============================================================

df = pd.read_csv(
    INPUT_FILE
)

print(
    "========================================"
)

print(
    "RELATIVE BAND EQUITY / DRAWDOWN ANALYSIS"
)

print(
    "========================================"
)

print(
    f"\n読み込み件数: {len(df)}"
)


# ============================================================
# 必要列確認
# ============================================================

required_columns = [
    "entry_time",
    "entry_band_distance_pips",
    "entry_atr14_pips",
    "profit",
]

missing_columns = [
    column
    for column in required_columns
    if column not in df.columns
]

if missing_columns:
    raise ValueError(
        "必要な列がありません: "
        + ", ".join(missing_columns)
    )


# ============================================================
# 型変換
# ============================================================

df["entry_time"] = pd.to_datetime(
    df["entry_time"],
    errors="coerce"
)

numeric_columns = [
    "entry_band_distance_pips",
    "entry_atr14_pips",
    "profit",
]

for column in numeric_columns:

    df[column] = pd.to_numeric(
        df[column],
        errors="coerce"
    )


# ============================================================
# 分析対象データ
# ============================================================

analysis_df = df[
    df["entry_time"].notna()
    &
    df["entry_band_distance_pips"].notna()
    &
    df["entry_atr14_pips"].notna()
    &
    df["profit"].notna()
    &
    (
        df["entry_atr14_pips"] > 0
    )
].copy()

if analysis_df.empty:
    raise ValueError(
        "分析対象データがありません。"
    )


# ============================================================
# Relative Band Distance
# ============================================================

analysis_df[
    "relative_band_distance"
] = (
    analysis_df[
        "entry_band_distance_pips"
    ]
    /
    analysis_df[
        "entry_atr14_pips"
    ]
)

analysis_df[
    "relative_band_distance"
] = (
    analysis_df[
        "relative_band_distance"
    ]
    .replace(
        [
            np.inf,
            -np.inf
        ],
        np.nan
    )
)

analysis_df = analysis_df[
    analysis_df[
        "relative_band_distance"
    ].notna()
].copy()


# ============================================================
# 時系列順
# ============================================================

analysis_df = (
    analysis_df
    .sort_values(
        "entry_time"
    )
    .reset_index(
        drop=True
    )
)

print(
    f"分析対象件数: {len(analysis_df)}"
)

print(
    f"分析開始日: "
    f"{analysis_df['entry_time'].min()}"
)

print(
    f"分析終了日: "
    f"{analysis_df['entry_time'].max()}"
)


# ============================================================
# PF
# ============================================================

def calculate_pf(profits):

    gross_profit = profits[
        profits > 0
    ].sum()

    gross_loss = -profits[
        profits < 0
    ].sum()

    if gross_loss == 0:

        if gross_profit > 0:
            return np.inf

        return np.nan

    return (
        gross_profit
        /
        gross_loss
    )


# ============================================================
# 条件抽出
# ============================================================

def filter_candidate(
    source_df,
    condition
):

    if condition is None:

        return (
            source_df
            .copy()
            .reset_index(drop=True)
        )

    lower, upper = condition

    filtered = source_df[
        (
            source_df[
                "relative_band_distance"
            ]
            >= lower
        )
        &
        (
            source_df[
                "relative_band_distance"
            ]
            <= upper
        )
    ].copy()

    return (
        filtered
        .sort_values(
            "entry_time"
        )
        .reset_index(
            drop=True
        )
    )


# ============================================================
# 資産曲線・DD計算
# ============================================================

def analyze_equity(
    candidate_df,
    initial_capital
):

    result = (
        candidate_df
        .copy()
        .reset_index(drop=True)
    )

    result[
        "trade_number"
    ] = (
        np.arange(
            len(result)
        )
        + 1
    )

    result[
        "cumulative_profit"
    ] = (
        result[
            "profit"
        ]
        .cumsum()
    )

    result[
        "equity"
    ] = (
        initial_capital
        +
        result[
            "cumulative_profit"
        ]
    )

    # 初期資金も過去最高値として扱う
    running_max_values = []

    running_max = initial_capital

    for equity in result["equity"]:

        running_max = max(
            running_max,
            equity
        )

        running_max_values.append(
            running_max
        )

    result[
        "running_max"
    ] = running_max_values

    result[
        "drawdown_amount"
    ] = (
        result[
            "equity"
        ]
        -
        result[
            "running_max"
        ]
    )

    result[
        "drawdown_pct"
    ] = (
        result[
            "drawdown_amount"
        ]
        /
        result[
            "running_max"
        ]
        * 100
    )

    return result


# ============================================================
# 最大DD情報
# ============================================================

def get_drawdown_info(
    equity_df,
    initial_capital
):

    if equity_df.empty:

        return {
            "max_drawdown_amount": np.nan,
            "max_drawdown_pct": np.nan,
            "dd_peak_time": pd.NaT,
            "dd_bottom_time": pd.NaT,
            "recovery_time": pd.NaT,
            "recovery_trades": np.nan,
        }

    bottom_index = (
        equity_df[
            "drawdown_pct"
        ]
        .idxmin()
    )

    bottom_row = (
        equity_df
        .loc[
            bottom_index
        ]
    )

    max_drawdown_amount = abs(
        bottom_row[
            "drawdown_amount"
        ]
    )

    max_drawdown_pct = abs(
        bottom_row[
            "drawdown_pct"
        ]
    )

    peak_equity = (
        bottom_row[
            "running_max"
        ]
    )

    before_bottom = (
        equity_df
        .loc[
            :bottom_index
        ]
    )

    peak_candidates = before_bottom[
        before_bottom[
            "equity"
        ]
        >= peak_equity
    ]

    if peak_candidates.empty:

        peak_time = pd.NaT
        peak_trade_number = 0

    else:

        peak_row = (
            peak_candidates
            .iloc[-1]
        )

        peak_time = (
            peak_row[
                "entry_time"
            ]
        )

        peak_trade_number = int(
            peak_row[
                "trade_number"
            ]
        )

    bottom_time = (
        bottom_row[
            "entry_time"
        ]
    )

    after_bottom = (
        equity_df
        .loc[
            bottom_index + 1:
        ]
    )

    recovery_candidates = after_bottom[
        after_bottom[
            "equity"
        ]
        >= peak_equity
    ]

    if recovery_candidates.empty:

        recovery_time = pd.NaT
        recovery_trades = np.nan

    else:

        recovery_row = (
            recovery_candidates
            .iloc[0]
        )

        recovery_time = (
            recovery_row[
                "entry_time"
            ]
        )

        recovery_trades = (
            int(
                recovery_row[
                    "trade_number"
                ]
            )
            -
            peak_trade_number
        )

    return {
        "max_drawdown_amount":
            max_drawdown_amount,

        "max_drawdown_pct":
            max_drawdown_pct,

        "dd_peak_time":
            peak_time,

        "dd_bottom_time":
            bottom_time,

        "recovery_time":
            recovery_time,

        "recovery_trades":
            recovery_trades,
    }


# ============================================================
# 分析
# ============================================================

summary_rows = []
equity_rows = []
drawdown_rows = []

equity_results = {}


for candidate_name, condition in CANDIDATES.items():

    candidate_df = filter_candidate(
        analysis_df,
        condition
    )

    if candidate_df.empty:

        print(
            f"\n{candidate_name}: "
            "対象取引なし"
        )

        continue

    equity_df = analyze_equity(
        candidate_df,
        INITIAL_CAPITAL
    )

    equity_results[
        candidate_name
    ] = equity_df

    profits = (
        candidate_df[
            "profit"
        ]
    )

    trades = len(
        candidate_df
    )

    wins = int(
        (
            profits > 0
        ).sum()
    )

    win_rate = (
        wins
        /
        trades
        *
        100
    )

    total_profit = (
        profits.sum()
    )

    average_profit = (
        profits.mean()
    )

    gross_profit = (
        profits[
            profits > 0
        ].sum()
    )

    gross_loss = -(
        profits[
            profits < 0
        ].sum()
    )

    profit_factor = (
        calculate_pf(
            profits
        )
    )

    final_equity = (
        equity_df[
            "equity"
        ]
        .iloc[-1]
    )

    dd_info = (
        get_drawdown_info(
            equity_df,
            INITIAL_CAPITAL
        )
    )

    summary_rows.append(
        {
            "candidate":
                candidate_name,

            "trades":
                trades,

            "wins":
                wins,

            "win_rate":
                win_rate,

            "total_profit":
                total_profit,

            "average_profit":
                average_profit,

            "gross_profit":
                gross_profit,

            "gross_loss":
                gross_loss,

            "profit_factor":
                profit_factor,

            "initial_capital":
                INITIAL_CAPITAL,

            "final_equity":
                final_equity,

            "max_drawdown_amount":
                dd_info[
                    "max_drawdown_amount"
                ],

            "max_drawdown_pct":
                dd_info[
                    "max_drawdown_pct"
                ],

            "dd_peak_time":
                dd_info[
                    "dd_peak_time"
                ],

            "dd_bottom_time":
                dd_info[
                    "dd_bottom_time"
                ],

            "recovery_time":
                dd_info[
                    "recovery_time"
                ],

            "recovery_trades":
                dd_info[
                    "recovery_trades"
                ],
        }
    )

    temp_equity = equity_df[
        [
            "entry_time",
            "trade_number",
            "profit",
            "cumulative_profit",
            "equity",
        ]
    ].copy()

    temp_equity[
        "candidate"
    ] = candidate_name

    equity_rows.append(
        temp_equity
    )

    temp_drawdown = equity_df[
        [
            "entry_time",
            "trade_number",
            "equity",
            "running_max",
            "drawdown_amount",
            "drawdown_pct",
        ]
    ].copy()

    temp_drawdown[
        "candidate"
    ] = candidate_name

    drawdown_rows.append(
        temp_drawdown
    )


# ============================================================
# DataFrame化
# ============================================================

summary_df = pd.DataFrame(
    summary_rows
)

equity_output_df = pd.concat(
    equity_rows,
    ignore_index=True
)

drawdown_output_df = pd.concat(
    drawdown_rows,
    ignore_index=True
)


# ============================================================
# CSV保存
# ============================================================

summary_df.to_csv(
    SUMMARY_CSV,
    index=False
)

equity_output_df.to_csv(
    EQUITY_CSV,
    index=False
)

drawdown_output_df.to_csv(
    DRAWDOWN_CSV,
    index=False
)


# ============================================================
# 資産曲線
# ============================================================

plt.figure(
    figsize=(12, 7)
)

for (
    candidate_name,
    equity_df
) in equity_results.items():

    plt.plot(
        equity_df[
            "entry_time"
        ],
        equity_df[
            "equity"
        ],
        label=candidate_name
    )

plt.axhline(
    INITIAL_CAPITAL,
    linestyle="--",
    linewidth=1
)

plt.title(
    "Equity Curve Comparison"
)

plt.xlabel(
    "Entry Time"
)

plt.ylabel(
    "Equity"
)

plt.legend()

plt.grid(
    alpha=0.3
)

plt.tight_layout()

plt.savefig(
    EQUITY_GRAPH,
    dpi=150
)

plt.close()


# ============================================================
# DD曲線
# ============================================================

plt.figure(
    figsize=(12, 7)
)

for (
    candidate_name,
    equity_df
) in equity_results.items():

    plt.plot(
        equity_df[
            "entry_time"
        ],
        equity_df[
            "drawdown_pct"
        ],
        label=candidate_name
    )

plt.axhline(
    0,
    linestyle="--",
    linewidth=1
)

plt.title(
    "Drawdown Curve Comparison"
)

plt.xlabel(
    "Entry Time"
)

plt.ylabel(
    "Drawdown (%)"
)

plt.legend()

plt.grid(
    alpha=0.3
)

plt.tight_layout()

plt.savefig(
    DRAWDOWN_GRAPH,
    dpi=150
)

plt.close()


# ============================================================
# 最大DD比較グラフ
# ============================================================

plot_df = (
    summary_df
    .sort_values(
        "max_drawdown_pct"
    )
    .copy()
)

plt.figure(
    figsize=(10, 6)
)

plt.bar(
    plot_df[
        "candidate"
    ],
    plot_df[
        "max_drawdown_pct"
    ]
)

plt.title(
    "Maximum Drawdown Comparison"
)

plt.xlabel(
    "Candidate"
)

plt.ylabel(
    "Maximum Drawdown (%)"
)

plt.xticks(
    rotation=20
)

plt.grid(
    axis="y",
    alpha=0.3
)

plt.tight_layout()

plt.savefig(
    MAX_DD_GRAPH,
    dpi=150
)

plt.close()


# ============================================================
# 結果表示
# ============================================================

print(
    "\n========================================"
)

print(
    "SUMMARY"
)

print(
    "========================================"
)

display_columns = [
    "candidate",
    "trades",
    "win_rate",
    "total_profit",
    "average_profit",
    "profit_factor",
    "final_equity",
    "max_drawdown_amount",
    "max_drawdown_pct",
    "dd_peak_time",
    "dd_bottom_time",
    "recovery_time",
    "recovery_trades",
]

print(
    summary_df[
        display_columns
    ].to_string(
        index=False
    )
)


print(
    "\n========================================"
)

print(
    "出力ファイル"
)

print(
    "========================================"
)

print(
    SUMMARY_CSV
)

print(
    EQUITY_CSV
)

print(
    DRAWDOWN_CSV
)

print(
    EQUITY_GRAPH
)

print(
    DRAWDOWN_GRAPH
)

print(
    MAX_DD_GRAPH
)
次回
次回は、
Relative Band Distanceの優位性が時間とともに変化した原因
を掘り下げます。
特に注目したいのが、
D:0.60~1.00
です。
Dは今回、
PF:1.861
最大DD:1.122%
平均損益:274円
という非常に強い結果を出しました。
しかし前回の期間別分析では、
2.554
↓
2.041
↓
1.646
↓
1.091
とPFが低下しています。
資産曲線でも2022年頃から伸びが明らかに鈍っています。
そこで次回は、Dを中心に、
取引数
勝率
平均利益
平均損失
平均損益
Gross Profit
Gross Loss
PF
が時間とともにどう変化したのかを分解します。
特に知りたいのは、
勝てなくなったのか

利益が小さくなったのか

損失が大きくなったのか

そもそも条件に該当する相場が減ったのか
という点です。
PFが低下したという結果だけでは、
なぜ優位性が低下したのか
までは分かりません。
ここを分解できれば、
Dを捨てるべきなのか

Cを採用すべきなのか

あるいは相場環境によってCとDを使い分けられるのか
まで踏み込める可能性があります。
次回はRelative Band Distanceの、
「時間劣化の正体」
を調べます。
コメント