はじめに
前回は、
BAND_DISTANCE ÷ ATRによって、バンドからの距離をそのときのボラティリティで正規化した、
Relative Band Distanceを分析しました。
結果は次のようになりました。
| グループ | 勝率 | 平均損益 | 中央値 | PF |
|---|---|---|---|---|
| Q1 | 73.84% | 80.25 | 258.52 | 1.283 |
| Q2 | 69.37% | 103.63 | 321.65 | 1.300 |
| Q3 | 60.09% | 142.33 | 271.15 | 1.412 |
| Q4 | 43.85% | 168.47 | -189.61 | 1.297 |
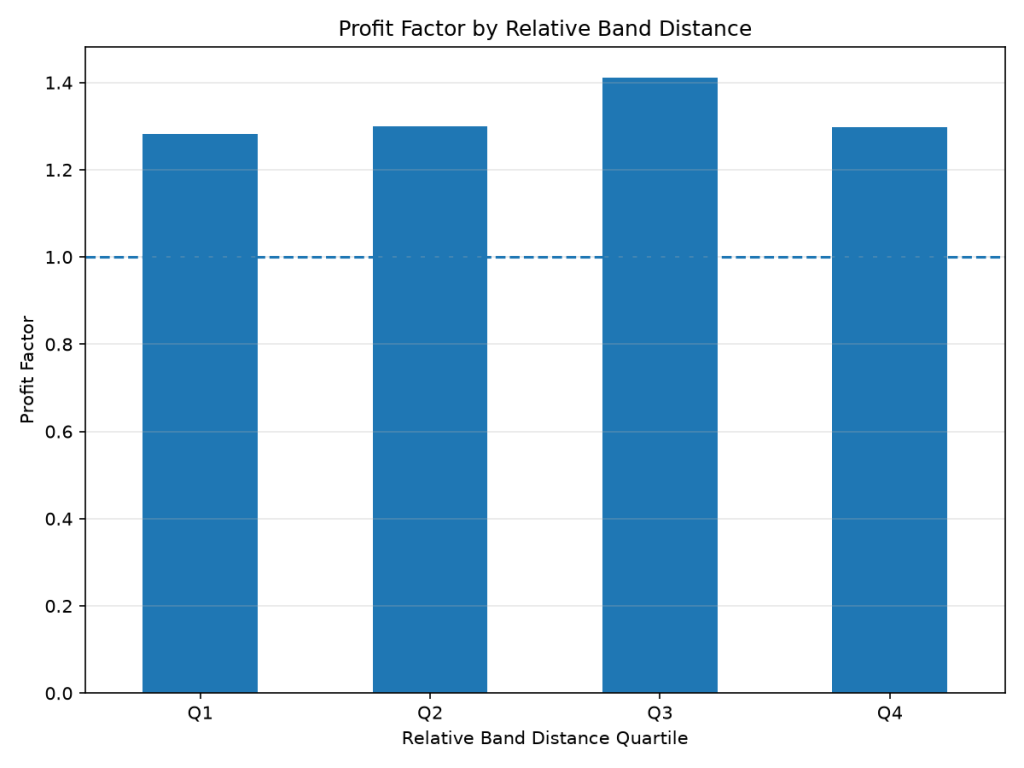
最もPFが高かったのはQ3でした。
一方で気になったのがQ4です。
Q4は勝率43.85%で、中央値も-189.61。
つまり、半分以上の取引が負けています。
それにもかかわらず、
- 平均損益:+168.47
- 総損益:+72,612
- PF:1.297
と、全体としては利益が残りました。
この結果から、
ごく一部の大きな利益が、多数の損失を補っているのではないか
という疑問が出てきます。
今回は、PFや平均損益だけではなく、利益の分布そのものを調べてみます。
なぜ平均値だけでは足りないのか
例えば、5回の取引結果が、
-100
-100
-100
-100
+1000
だったとします。
この場合、平均損益は、
+120
です。
平均値だけを見ると利益が出ています。
しかし実際には、5回中4回は負けています。
このように、
少数の非常に大きな利益
があると、平均値は大きく引っ張られます。
トレンドフォローでは、このような分布自体は珍しくありません。
小さな損失を繰り返しながら、大きなトレンドを捕まえたときに利益を伸ばすからです。
ただし、
どの程度大勝ちに依存しているのか
は確認しておく必要があります。
今回調べたいこと
今回は”Relative Band Distance”のQ1~Q4について、次の項目を調べます。
- 取引数
- 平均損益
- 中央値
- 最大利益
- 最大損失
- 25%点
- 75%点
- 90%点
- 95%点
- 通常のPF
- 上位10%の勝ち取引が総利益の何%を占めるか
- 上位5%の勝ち取引が総利益の何%を占めるか
- 上位10%の勝ち取引を除外した場合のPF
- 上位5%の勝ち取引を除外した場合のPF
特に注目するのはQ3とQ4です。
前回、
Q3はPFが最高
Q4は平均損益が最高だが中央値がマイナス
という違いがありました。
もしQ3が上位の大勝ちを除いてもPF1付近を維持する一方、Q4だけPFが大きく崩れるなら、
Q3の方が比較的安定した優位性を持ち、Q4はホームラン依存型
という可能性があります。
データを準備する
今回も、
results/trade_base.csvを使用します。
まず前回と同じRelative Band Distanceを作ります。
analysis_df["relative_band_distance"] = (
    analysis_df["entry_band_distance_pips"]
    /
    analysis_df["entry_atr14_pips"]
)
そして四分位に分けます。
analysis_df["relative_band_group"] = pd.qcut(
    analysis_df["relative_band_distance"],
    q=4,
    labels=[
        "Q1",
        "Q2",
        "Q3",
        "Q4"
    ]
)
これで、第19回と同じ条件で比較できます。
損益分布を見る
まず各グループについて、
- 最小値
- 25%点
- 中央値
- 75%点
- 90%点
- 95%点
- 最大値
を計算します。
これまで平均値を中心に見てきましたが、今回は、
取引結果が実際にどの範囲へ分布しているのか
を確認します。
上位10%の勝ち取引は総利益の何%を作っているのか
次に、各グループの勝ち取引だけを取り出します。
その中から利益額の大きい順に並べ、
上位10%の取引が、そのグループの総利益の何%を作っているのか
を計算します。
例えば、総利益100万円のうち、上位10%の取引だけで70万円を稼いでいた場合、
上位10%利益寄与率 = 70%
です。
この値が高いほど、
少数の大勝ちへの依存度が高い
と考えられます。
同様に上位5%についても確認します。
大勝ちを除いたらPFはどうなるか
さらに踏み込んで、
上位10%の勝ち取引を除外した場合
のPFも再計算します。
これはかなり厳しいテストです。
トレンドフォロー戦略では大きな利益を取ること自体が戦略の一部なので、
大勝ちを除外してPF1を割ったから戦略として悪い
という意味ではありません。
むしろ、
収益構造がどれだけ大勝ちに依存しているのか
を見るためのストレステストです。
上位10%を除いてもPFが1付近に残るのであれば、比較的広い取引から利益を得ています。
一方、PFが大幅に低下するのであれば、
少数の大きなトレンドを捕まえることが収益の中心
であることが分かります。
箱ひげ図でも確認する
数値だけでは分布が分かりにくいため、箱ひげ図も作ります。
箱ひげ図では、
- 中央値
- 25%点
- 75%点
- 外れ値
を視覚的に確認できます。
今回は特にQ4について、
多数のマイナス取引の右側に、巨大なプラスの外れ値が存在しているのか
を見てみます。
ただし極端な利益が存在するとグラフ全体が潰れてしまう可能性があります。
そのため、
- 全取引版
- 上下1%を除いた拡大版
の2種類を出力します。
今回の分析で分かること
ここまでの分析では、
どの条件でPFが高いか
を中心に見てきました。
しかしPFが同じ1.4であっても、
タイプA
多くの取引で少しずつ利益

タイプB
多数の小さな損失
+
数回の巨大な利益
では意味がまったく違います。
今回の分析では、
零号機の利益がどのような形で作られているのか
まで踏み込みます。
これによって、単なる条件別成績ではなく、
零号機という戦略そのものの性格
が少しずつ見えてくるはずです。
Pythonによる分析コードの解説
今回もPythonのpandasとMatplotlibを使用して、零号機の取引データを分析します。
分析の流れは、次のとおりです。
- データの読み込みと分析対象の抽出
- Relative Band Distanceによる四分位への分類
- Q1~Q4の損益分布の集計
- 上位5%・10%の勝ち取引の利益寄与率を計算
- 大勝ちを除外した場合のPFを再計算
- 箱ひげ図と棒グラフによる可視化
データの読み込みと分析対象の抽出
まず、CSVファイルから取引データを読み込みます。
df = pd.read_csv(
    INPUT_FILE
)
pd.read_csv() は、CSVファイルを読み込んでDataFrameを作成する関数です。
今回使用するのは、これまでと同じ results/trade_base.csv です。
続いて、分析に必要な列が存在するかを確認します。
required_columns = [
    "entry_band_distance_pips",
    "entry_atr14_pips",
    "profit"
]

missing_columns = [
    column
    for column in required_columns
    if column not in df.columns
]
required_columns は、分析に必要な列名を格納したリストです。
missing_columns では、リスト内包表記を使い、DataFrameに存在しない列名を抽出しています。
df.columns はDataFrameの列名一覧を取得するものです。
column not in df.columns によって、必要な列が存在しないか確認しています。
続いて、必要な列を数値型に変換します。
for column in required_columns:
    df[column] = pd.to_numeric(
        df[column],
        errors="coerce"
    )
pd.to_numeric() は、データを数値型に変換する関数です。
errors="coerce" は、数値に変換できない値を NaN(欠損値)に変換する指定です。
次に、分析対象となる取引を抽出します。
analysis_df = df[
    df["entry_band_distance_pips"].notna()
    &
    df["entry_atr14_pips"].notna()
    &
    df["profit"].notna()
    &
    (df["entry_atr14_pips"] > 0)
].copy()
.notna() は、欠損値ではないデータを判定するメソッドです。
今回は、バンド距離・ATR・損益の3項目が欠損しておらず、さらにATRが0より大きい取引だけを抽出しています。
ATRを0より大きい値に限定しているのは、次の処理でATRを分母として使用するためです。
Relative Band Distanceの計算と四分位への分類
前回と同様、バンドからの距離をATRで割り、Relative Band Distanceを計算します。
analysis_df["relative_band_distance"] = (
    analysis_df["entry_band_distance_pips"]
    /
    analysis_df["entry_atr14_pips"]
)
例えば、バンド距離が10pips、ATRが5pipsであれば、Relative Band Distanceは2.0となります。
同じ10pipsでもATRが20pipsであれば0.5となります。
つまり、相場のボラティリティに対して、どの程度強くバンドを抜けているのかを表しています。
続いて、無限大の値を欠損値に置き換え、分析対象から除外します。
analysis_df["relative_band_distance"] = (
    analysis_df["relative_band_distance"]
    .replace(
        [np.inf, -np.inf],
        np.nan
    )
)

analysis_df = analysis_df[
    analysis_df["relative_band_distance"].notna()
].copy()
.replace() は、指定した値を別の値に置き換えるメソッドです。
np.inf と -np.inf は、それぞれ正の無限大と負の無限大を表します。
続いて、Relative Band Distanceを四分位に分けます。
quartile_order = [
    "Q1",
    "Q2",
    "Q3",
    "Q4"
]

analysis_df["relative_band_group"] = pd.qcut(
    analysis_df["relative_band_distance"],
    q=4,
    labels=quartile_order
)
pd.qcut() は、データを件数がおおむね等しくなるように分割する関数です。
q=4 は4つのグループに分割する指定です。
labels=quartile_order によって、各グループにQ1~Q4の名前を付けています。
これで前回と同じ分類を使用して分析できます。
PFを計算する関数を作成する
今回の分析では、通常のPFだけでなく、大勝ちを除外した後のPFも計算します。
そこで、PFを計算する処理を関数として定義します。
def calculate_pf(data):
    gross_profit = (
        data.loc[
            data["profit"] > 0,
            "profit"
        ].sum()
    )

    gross_loss = abs(
        data.loc[
            data["profit"] < 0,
            "profit"
        ].sum()
    )

    if gross_loss == 0:
        return np.nan

    return gross_profit / gross_loss
data.loc[] は、条件を指定して行と列を取り出すメソッドです。
data["profit"] > 0 で勝ち取引だけを抽出し、.sum() で総利益を計算します。
同様に、data["profit"] < 0 で負け取引だけを抽出します。
abs() は絶対値を取得する関数です。
総損失は通常マイナスのため、絶対値に変換します。
最後に、総利益を総損失の絶対値で割ってPFを求めます。
なお、総損失が0の場合はゼロ除算を避けるため、np.nan を返すようにしています。
Q1~Q4の損益分布を計算する
次に、各グループの損益分布を集計します。
summary_rows = []

for group_name in quartile_order:
    group_df = analysis_df[
        analysis_df["relative_band_group"] == group_name
    ].copy()

    profit = group_df["profit"]
summary_rows = [] は、集計結果を保存するための空のリストを作成しています。
for group_name in quartile_order: は、Q1~Q4を順番に処理するための繰り返し処理です。
group_df には、現在処理しているグループの取引だけを抽出します。
例えば、group_name が "Q1" であれば、Q1に属する取引だけが抽出されます。
さらに、group_df["profit"] によって損益列を取り出し、profit に格納します。
続いて、この損益データを使って統計量を計算します。
| コード | 意味 |
|---|---|
sum() | 総損益 |
mean() | 平均損益 |
min() | 最小値(最大損失) |
max() | 最大値(最大利益) |
median() | 中央値 |
quantile(0.25) | 25%点 |
quantile(0.75) | 75%点 |
quantile(0.90) | 90%点 |
quantile(0.95) | 95%点 |
quantile() は、データを小さい順に並べたときの指定した割合に対応する値を求めるメソッドです。
例えば、quantile(0.95) は95%点を求めます。
平均値と中央値の差や、95%点と最大利益の差を確認することで、損益分布の偏りを調べます。
また、勝率は次のように計算します。
(profit > 0).mean() * 100profit > 0 によって、勝ち取引を True、それ以外を False として判定します。
Pythonでは True を1、False を0として扱えるため、.mean() で平均を求めると勝ち取引の割合になります。
最後に100を掛けて百分率に変換します。
なお、損益が0の取引は勝ちには含まれません。
これらの計算結果を辞書にまとめ、.append() で summary_rows に追加します。
summary_rows.append(
    {
        "group": group_name,
        "trades": len(group_df),
        "average_profit": profit.mean(),
        "median_profit": profit.median(),
        "profit_factor": calculate_pf(group_df)
    }
)
.append() は、リストの末尾に要素を追加するメソッドです。
Q1~Q4の処理が終わったら、リストをDataFrameに変換します。
summary_df = pd.DataFrame(
    summary_rows
)

summary_df = summary_df.set_index(
    "group"
)
pd.DataFrame() は、リストなどのデータからDataFrameを作成する関数です。
summary_rowsは、辞書を格納したリストでした。
.set_index("group") は、group 列をインデックスに設定するメソッドです。
これで、Q1~Q4を行とする損益分布の集計表が完成します。
上位5%・10%の勝ち取引の利益寄与率を計算する
次に、少数の大勝ちが総利益の何%を占めているのかを計算します。
まず、各グループから勝ち取引だけを抽出します。
winning_df = group_df[
    group_df["profit"] > 0
].copy()
profit > 0 は、損益がプラスの取引だけを抽出する条件です。
続いて、利益の大きい順に並べます。
winning_df = winning_df.sort_values(
    by="profit",
    ascending=False
)
.sort_values() は、指定した列の値を基準に並べ替えるメソッドです。
by="profit" は損益列を基準にする指定です。
ascending=False は降順、つまり大きい順に並べる指定です。
これによって、最も大きな利益を出した取引が先頭に並びます。
次に、勝ち取引の件数を取得します。
win_count = len(winning_df)len() は、データの件数を取得する関数です。
続いて、上位10%と上位5%に相当する取引数を計算します。
top_10_count = max(
    1,
    math.ceil(win_count * 0.10)
)

top_5_count = max(
    1,
    math.ceil(win_count * 0.05)
)
math.ceil() は、小数点以下を切り上げる関数です。
例えば、勝ち取引が83回の場合、上位10%は8.3回となるため、切り上げて9回とします。
max() は、指定した値のうち、最も大きい値を返す関数です。max(1, ...) は、最低でも1件を対象とするために指定しています。
次に、上位の勝ち取引だけを取り出し、利益を合計します。
top_10_profit = (
    winning_df
    .head(top_10_count)["profit"]
    .sum()
)

top_5_profit = (
    winning_df
    .head(top_5_count)["profit"]
    .sum()
)
.head() は、先頭から指定した件数のデータを取得するメソッドです。
すでに利益の大きい順に並べているため、上位10%・5%の勝ち取引だけを取り出せます。
次に、総利益に対する割合を計算します。
gross_profit = winning_df["profit"].sum()

if gross_profit > 0:
    top_10_share = (
        top_10_profit / gross_profit * 100
    )

    top_5_share = (
        top_5_profit / gross_profit * 100
    )
else:
    top_10_share = np.nan
    top_5_share = np.nan
gross_profit は、すべての勝ち取引の利益を合計したものです。
上位10%の利益を総利益で割り、100を掛けることで利益寄与率を求めます。
例えば、総利益が100万円で、上位10%の勝ち取引の利益が40万円であれば、利益寄与率は40%となります。
if gross_profit > 0: は、総利益が0の場合にゼロ除算が発生することを防ぐための条件です。
この分析によって、Q1~Q4のどのグループが少数の大勝ちに依存しているのかを比較できます。
大勝ちを除外した場合のPFを再計算する
続いて、今回の分析で特に重要なストレステストを実施します。
各グループについて、上位5%・10%の勝ち取引を除外し、PFがどの程度変化するのかを調べます。
まず、通常のPFを計算します。
original_pf = calculate_pf(
    group_df
)
続いて、先ほどと同じように勝ち取引を利益の大きい順に並べ、上位の取引のインデックスを取得します。
top_10_indices = (
    winning_df
    .head(top_10_count)
    .index
)

top_5_indices = (
    winning_df
    .head(top_5_count)
    .index
)
.index は、対象となる行のインデックスを取得するものです。
ここでは、上位10%・5%の勝ち取引に該当する行のインデックスを取得しています。
次に、その取引を除外します。
without_top_10 = group_df.drop(
    index=top_10_indices
)

without_top_5 = group_df.drop(
    index=top_5_indices
)
.drop() は、指定した行や列を削除したDataFrameを返すメソッドです。
index= によって、削除する行のインデックスを指定しています。
これにより、大勝ちを除外した取引データを作成できます。
なお、元の group_df 自体は変更されません。
続いて、PFを再計算します。
pf_without_top_10 = calculate_pf(
    without_top_10
)

pf_without_top_5 = calculate_pf(
    without_top_5
)
先ほど定義した calculate_pf() を使い、残った取引だけでPFを計算しています。
さらに、総損益も計算します。
total_profit_without_top_10 = (
    without_top_10["profit"].sum()
)

total_profit_without_top_5 = (
    without_top_5["profit"].sum()
)
この結果を通常のPFと比較することで、少数の大勝ちが失われた場合に収益性がどの程度低下するのかを確認できます。
ただし、これは大勝ちを除外した方がよいかを判断するための分析ではありません。
トレンドフォロー戦略において、大きな利益を獲得すること自体が重要な戦略要素だからです。
あくまで、利益が少数の大勝ちにどの程度依存しているのかを測るためのストレステストです。
箱ひげ図で損益分布を可視化する
次に、損益分布を視覚的に比較するため、Matplotlibで箱ひげ図を作成します。
箱ひげ図(ボックスプロット)とは、データのばらつきや中央値、外れ値などを視覚的に確認できるグラフです
まず、Q1~Q4それぞれの損益データを取り出します。
boxplot_data = [
    analysis_df.loc[
        analysis_df["relative_band_group"] == group,
        "profit"
    ]
    for group in quartile_order
]
これはリスト内包表記を使っているので、for文が最後に来ています。
リスト内法表記では、以下のように記述します。
[追加したい値 for 変数 in 繰り返すデータ].loc[] は、行と列を指定してデータを抽出するメソッドです。
for group in quartile_order によってQ1~Q4を順番に処理し、.loc[] で各グループの損益データを取り出しています。
続いて、箱ひげ図を描画します。
fig, ax = plt.subplots(
    figsize=(9, 6)
)

ax.boxplot(
    boxplot_data,
    tick_labels=quartile_order
)
plt.subplots() は、図全体を表すFigureと、描画領域を表すAxesを作成する関数です。
figsize=(9, 6) は、図の大きさを横9インチ、縦6インチに設定しています。
ax.boxplot() は、箱ひげ図を描画するメソッドです。
tick_labels=quartile_order は、横軸の目盛りにQ1~Q4を表示する指定です。
さらに、損益0の位置に補助線を引きます。
ax.axhline(
    y=0,
    linestyle="--"
)
ax.axhline() は、指定した高さに水平線を引くメソッドです。
y=0 は損益0の位置、linestyle="--" は破線を指定しています。
これにより、各グループの損益がプラス側とマイナス側のどちらに分布しているのかを確認しやすくなります。
最後に、グラフを保存します。
plt.tight_layout()

plt.savefig(
    OUTPUT_BOXPLOT,
    dpi=150
)

plt.close()
plt.tight_layout() は、グラフ内の文字や目盛りが重ならないように余白を調整します。
plt.savefig() は、グラフを画像ファイルとして保存する関数です。
dpi=150 は、画像の解像度を指定しています。
plt.close() は、作成した図を閉じる関数です。
上下1%を除いた箱ひげ図を作成する
今回のデータには、非常に大きな利益や損失が含まれています。
そのため、すべての取引を表示すると、箱ひげ図の中心部分が見づらくなる可能性があります。
そこで、上下1%を除いた箱ひげ図も作成します。
lower_limit = (
    analysis_df["profit"].quantile(0.01)
)

upper_limit = (
    analysis_df["profit"].quantile(0.99)
)
quantile(0.01) は下位1%点、quantile(0.99) は上位1%点を取得します。
次に、その範囲内の取引だけを抽出します。
trimmed_df = analysis_df[
    (analysis_df["profit"] >= lower_limit)
    &
    (analysis_df["profit"] <= upper_limit)
].copy()
これにより、極端に大きな利益や損失を除いたデータを作成できます。
なお、上下1%の基準は、Q1~Q4それぞれではなく、分析対象の全取引から計算しています。
このデータを使って、先ほどと同じ方法で箱ひげ図を作成します。
全取引版と上下1%を除いた拡大版を比較することで、極端な外れ値と通常の取引の分布をそれぞれ確認できます。
上位利益寄与率を棒グラフで比較する
続いて、上位5%・10%の勝ち取引が総利益に占める割合を棒グラフで比較します。
contribution_plot_df = contribution_df[
    [
        "top_5_profit_share",
        "top_10_profit_share"
    ]
]
contribution_df から、上位5%と上位10%の利益寄与率を表す列だけを取り出しています。
次に、棒グラフを作成します。
fig, ax = plt.subplots(
    figsize=(9, 6)
)

contribution_plot_df.plot(
    kind="bar",
    ax=ax
)
.plot() は、pandasのDataFrameからグラフを作成するメソッドです。
kind="bar" は、棒グラフを指定しています。
ax=ax は、先ほど作成した描画領域にグラフを表示する指定です。
これにより、Q1~Q4それぞれについて、上位5%と上位10%の利益寄与率を比較できます。
PFのストレステスト結果を棒グラフで比較する
最後に、通常のPFと、大勝ちを除外した後のPFを棒グラフで比較します。
stress_plot_df = stress_df[
    [
        "original_pf",
        "pf_without_top_5_percent_winners",
        "pf_without_top_10_percent_winners"
    ]
]
stress_df から、通常のPF、上位5%除外後のPF、上位10%除外後のPFを取り出しています。
続いて、棒グラフを作成します。
fig, ax = plt.subplots(
    figsize=(9, 6)
)

stress_plot_df.plot(
    kind="bar",
    ax=ax
)

ax.axhline(
    y=1.0,
    linestyle="--"
)
kind="bar" によって、3種類のPFを棒グラフとして表示します。
ax.axhline(y=1.0) は、PF1.0の位置に水平線を引く処理です。
PFが1を上回れば総利益が総損失を上回り、1を下回れば総損失の方が大きいことを意味します。
このグラフによって、上位の勝ち取引を除外したとき、各グループのPFがどの程度低下するのかを視覚的に比較できます。
以上で、今回の分析に必要な集計とグラフの作成が完了しました。
出力されるファイル
今回のコードでは、
results/
├─ profit_distribution_analysis.csv
├─ profit_contribution_analysis.csv
├─ profit_stress_test.csv
├─ profit_distribution_boxplot.png
├─ profit_distribution_boxplot_trimmed.png
├─ top_profit_contribution.png
└─ profit_factor_stress_test.png
を出力します。
特に重要なのは、
profit_distribution_analysis.csv
profit_contribution_analysis.csv
profit_stress_test.csv
の3つです。
この3ファイルを見ることで、
Q3とQ4ではどちらが大勝ちに依存しているのか
零号機の利益は上位5%・10%の取引にどれくらい集中しているのか
大勝ちを取り除いた場合に各グループのPFがどこまで崩れるのか
を比較できます。
次に、実際の分析結果を確認します。
分析結果
今回は、Relative Band DistanceのQ1~Q4について、単純なPFや平均損益だけではなく、
「利益がどのような分布から生まれているのか」
を調べました。
まず、各グループの損益分布は次のようになりました。
| グループ | 勝率 | 平均損益 | 中央値 | 25%点 | 75%点 | 95%点 | 最大利益 | 最大損失 | PF |
|---|---|---|---|---|---|---|---|---|---|
| Q1 | 73.84% | 80.25 | 258.52 | -27.11 | 529.96 | 1,079.14 | 3,320.04 | -6,217.99 | 1.283 |
| Q2 | 69.37% | 103.63 | 321.65 | -151.78 | 665.68 | 1,413.70 | 4,821.95 | -12,814.89 | 1.300 |
| Q3 | 60.09% | 142.33 | 271.15 | -332.32 | 678.30 | 1,678.82 | 7,261.58 | -6,104.37 | 1.412 |
| Q4 | 43.85% | 168.47 | -189.61 | -659.86 | 902.32 | 3,158.40 | 25,936.77 | -17,965.37 | 1.297 |
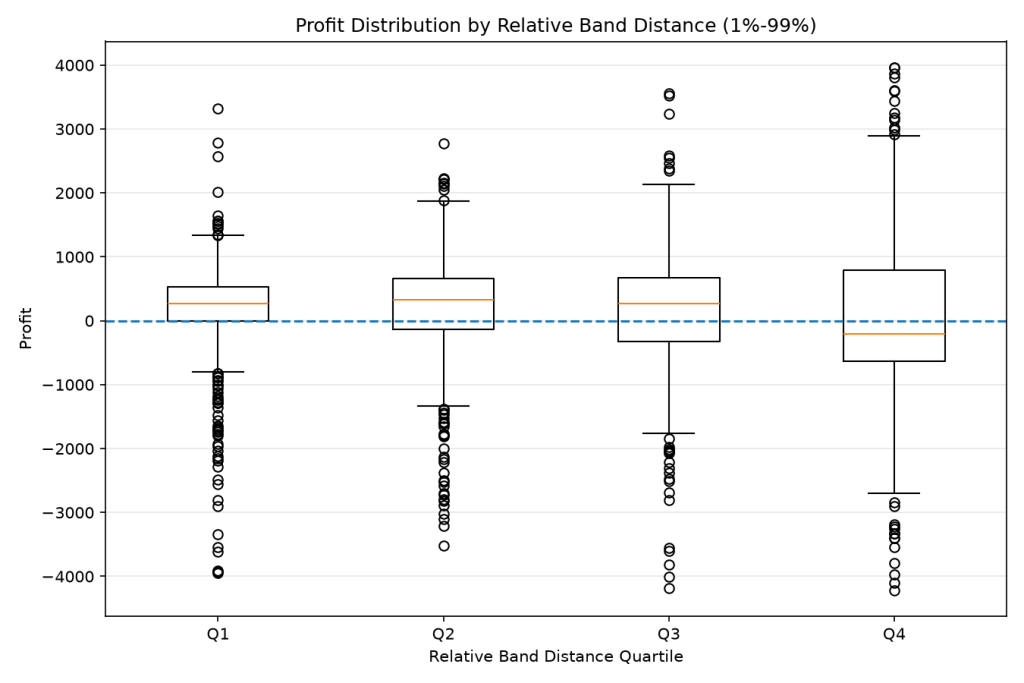
なお、箱ひげ図では以下のように見ます。
- 中央値(箱の中の線):データの中心がどこにあるか
- 箱の大きさ:箱にはデータの中央50%が含まれ、箱が大きいほどばらつきが大きいことを意味する
- ひげの長さ:データがどの程度広がっているか
- 外れ値(ひげの外側の点):極端に大きな値や小さな値が存在するか
ここでも前回と同じように、Q4だけかなり異質な分布になっています。
Q1~Q3は中央値がプラス、Q4だけマイナス
まず中央値を見ると、
Q1  +258.52
Q2  +321.65
Q3  +271.15
Q4  -189.61
となりました。
Q1~Q3では、「典型的な取引」はプラスです。
一方Q4だけは中央値がマイナスになっています。
つまりQ4では、
半分以上の取引が損失側にある
にもかかわらず、平均損益は4グループで最も高いという状態です。
これは平均値が一部の大きな利益に強く引っ張られていることを示しています。
Q4は利益側の裾が非常に長い
最大利益を見ると、
Q1   3,320.04
Q2   4,821.95
Q3   7,261.58
Q4  25,936.77
となりました。
Q4の最大利益は、Q3の約3.6倍です。
95%点についても、
Q1  1,079.14
Q2  1,413.70
Q3  1,678.82
Q4  3,158.40
となっており、Q4だけかなり大きくなっています。
箱ひげ図でも、Q4には1万を大きく超える利益や2万を超える利益が存在しています。
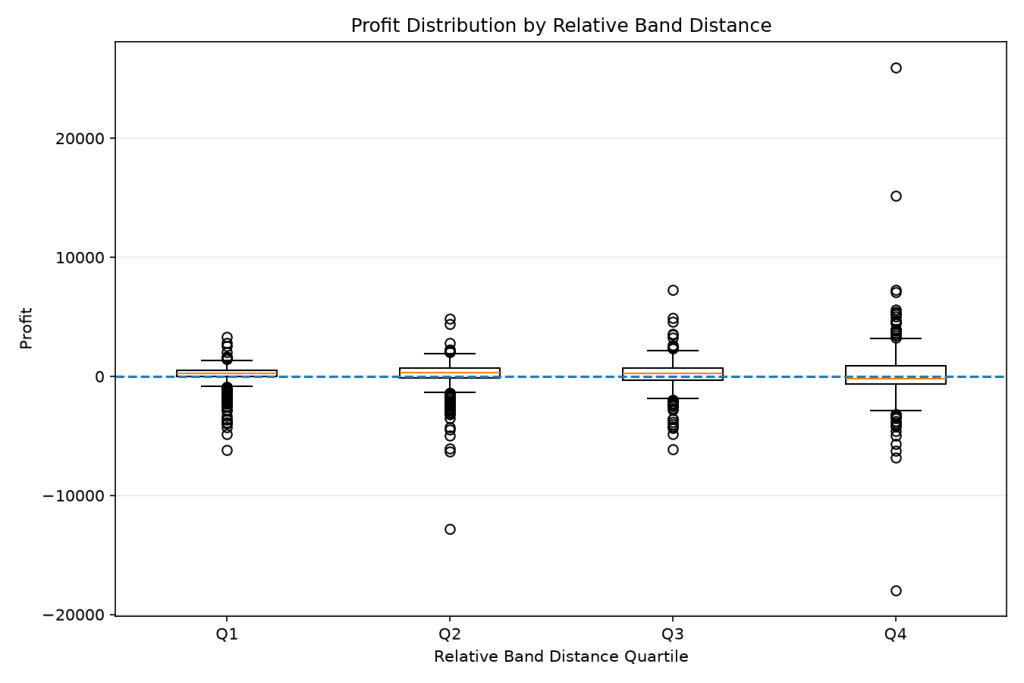
Q4では、
普段の取引はそれほど強くない一方、ごく一部で巨大な利益が発生する
という特徴がかなり明確です。
一方でQ4は損失側も大きい
ただし、Q4は利益側だけが大きいわけではありません。
最大損失を見ると、
Q1   -6,217.99
Q2  -12,814.89
Q3   -6,104.37
Q4  -17,965.37
でした。
Q4は最大利益が最も大きい一方、最大損失も最も大きくなっています。
さらに25%点も、
Q1   -27.11
Q2  -151.78
Q3  -332.32
Q4  -659.86
と、Relative Band Distanceが大きくなるほど損失側へ広がっています。
つまりQ4は、
大きく勝つ可能性もあるが、大きく負ける可能性もある
非常に振れ幅の大きな取引群です。
上位10%の勝ち取引がどれだけ利益を作っているか
次に、各グループの勝ち取引について、
利益額上位10%の取引が、総利益の何%を占めているのか
を計算しました。
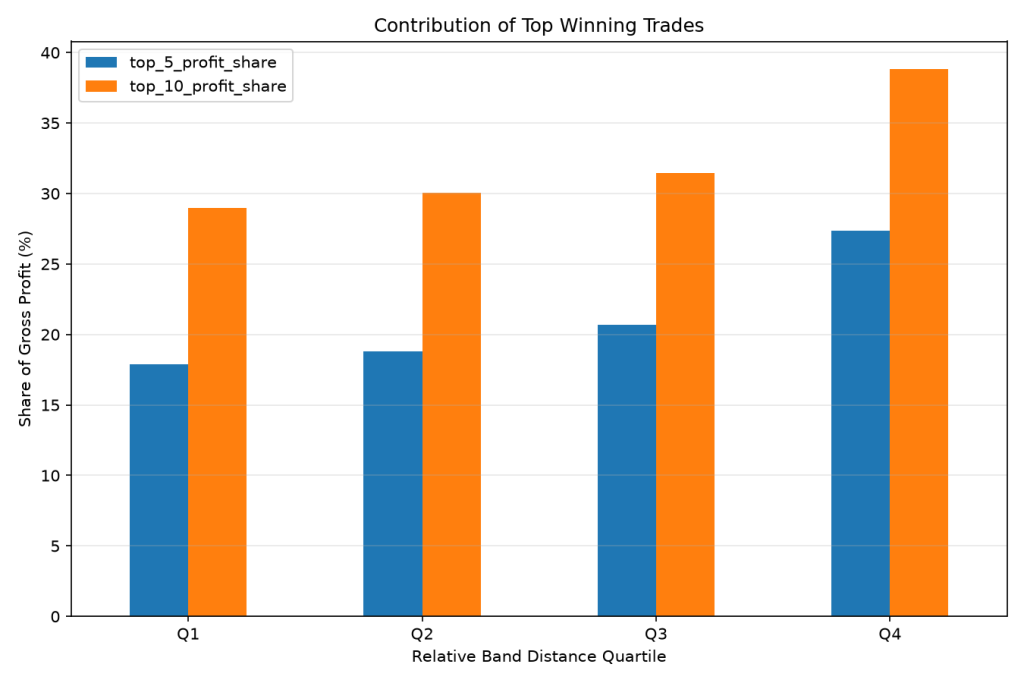
結果は、
Q1  28.95%
Q2  30.06%
Q3  31.46%
Q4  38.85%
となりました。
Q1~Q3では、おおむね30%前後です。
一方Q4では、
上位10%の勝ち取引だけで総利益の38.85%
を作っています。
さらに上位5%だけを見ると、
Q1  17.88%
Q2  18.80%
Q3  20.68%
Q4  27.38%
でした。
Q4では、わずか10件の大きな勝ち取引だけで、総利益の27.38%を占めています。
この結果からも、
Q4は他のグループより明らかに少数の大勝ちへの依存度が高い
ことが分かります。
「大勝ちを取り除く」ストレステスト
ここからが今回最も重要な分析です。
各グループについて、利益額上位5%の勝ち取引を削除し、PFを再計算しました。
結果は、
| グループ | 通常PF | 上位5%除外 | 上位10%除外 |
|---|---|---|---|
| Q1 | 1.283 | 1.054 | 0.912 |
| Q2 | 1.300 | 1.056 | 0.909 |
| Q3 | 1.412 | 1.120 | 0.968 |
| Q4 | 1.297 | 0.942 | 0.793 |
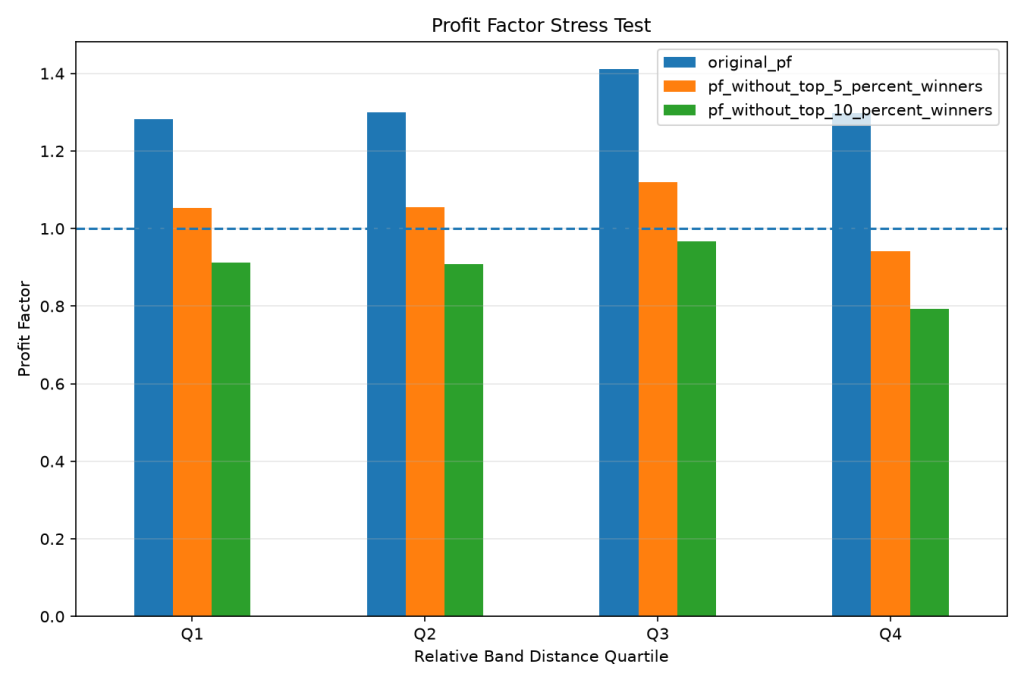
かなりはっきりと違いが出ました。
Q4は上位5%を除いただけでPF1を割った
Q4は通常状態では、
PF 1.297
でした。
しかし上位5%の勝ち取引を除くと、
PF 0.942
まで低下しました。
さらに上位10%を除くと、
PF 0.793
です。
総損益も、
通常
+72,612.18

上位5%除外
-14,123.82

上位10%除外
-50,471.73
となりました。
つまりQ4は、
上位5%程度の大きな勝ちが存在しなければ、そもそも利益が残らない
構造になっています。
第19回で、
Q4はホームラン型なのではないか
と考えましたが、今回の分析ではその傾向がかなり明確になりました。
ただし「ホームラン依存=悪い」ではない
Q4が一部の大勝ちに依存しているからといって、
Q4は悪い条件
とは言えません。
零号機はトレンドフォロー型です。
トレンドフォロー戦略では、
多数の小さな負けを受け入れながら、ごく少数の大きなトレンドを取り切る
という利益構造そのものが戦略の特徴です。
その大勝ちを意図的に削除すれば、PFが大きく低下するのはある意味当然とも言えます。
今回のストレステストは、
大勝ちを除いた方が良いか
を見るためではありません。
利益がどの程度大勝ちに依存しているのか
を測るための分析です。
その意味で、Q4はかなり強い「ホームラン依存型」であることが分かりました。
ではQ3はどうか
一方、かなり興味深いのがQ3です。
Q3はもともと、
PF 1.412
と4グループ中最高でした。
上位5%の勝ち取引を除いても、
PF 1.120
を維持しています。
総損益も、
+17,844.97
です。
つまりQ3は、
最上位の大勝ちをいくつか取り除いても、まだ利益が残っている
唯一のグループではありませんが、その耐性は4グループ中最も高くなりました。
上位10%を除くとPF0.968となり1をわずかに下回りますが、Q1の0.912、Q2の0.909、Q4の0.793より高い値です。
この結果を見る限り、
Q3はQ4よりも広い範囲の取引から利益を得ている
可能性があります。
Q3とQ4は同じ「トレンドフォロー型」でも性格が違う
ここまでを見ると、Q3とQ4の違いがかなり見えてきました。
Q3
- 勝率60.09%
- 中央値+271.15
- PF1.412
- 上位5%除外後もPF1.120
- 上位10%除外後もPF0.968
つまり、
大きな利益も存在するが、それだけに依存せず比較的広い取引で利益を積み上げている
タイプです。
一方Q4は、
- 勝率43.85%
- 中央値-189.61
- 最大利益25,936.77
- 上位10%が総利益の38.85%
- 上位5%除外だけでPF0.942
となりました。
こちらは、
普段は負けることの方が多いが、たまに発生する非常に大きなトレンドで利益を作る
タイプです。
同じ零号機の中でも、Relative Band Distanceによって利益の作り方そのものが変わっている可能性があります。
Q3は今のところ最も興味深いゾーン
ここ数回の分析を振り返ると、Q3はかなり興味深い位置にあります。
Relative Band Distance分析では、
PF1.412
と最高でした。
今回のストレステストでも、
上位5%の勝ちを除いてPF1.120
と最も高い耐性を示しました。
一方で、Q4ほど極端な外れ値には依存していません。
つまり現時点では、
「相場のボラティリティに対して、ある程度強くバンドを抜けているが、極端には伸び切っていない」
領域が、零号機にとって比較的安定した条件なのではないか、という仮説が強くなってきました。
ただし、まだこれをエントリーフィルターに使う段階ではありません。
今回のまとめ
今回、零号機の利益分布を分析したことで、PFだけを見ていたときには分からなかった違いが見えてきました。
特に重要なのは、
Q3とQ4では利益の作り方がかなり違う
という点です。
Q4は、
多数の負け + 少数の巨大な勝ち
という典型的なホームラン型でした。
上位5%の勝ちを除くだけでPFは1を割りました。
一方Q3は、
大勝ちも存在するが、比較的広い取引から利益を得ている
構造でした。
上位5%を除いてもPF1.120を維持しています。
ここまでの結果から、
Q4は「当たれば大きい」
Q3は「比較的安定して利益を作る」
という違いがありそうです。
しかし、このQ3の優位性が過去データ全体にわたって安定して存在していたのかは、まだ分かりません。
たまたま一部の期間だけQ3が強かった可能性もあります。
そこで次は、時間軸を加えて分析してみたいと思います。
次回は、この結果を使って零号機の「利益の作り方」そのものを分析します。
今回のコード全文
ファイル名:
profit_distribution_analysis.py
コード全文を見る
import os
import math
import numpy as np
import pandas as pd
import matplotlib.pyplot as plt


# ============================================================
# 設定
# ============================================================

INPUT_FILE = "results/trade_base.csv"

OUTPUT_DIR = "results"

os.makedirs(
    OUTPUT_DIR,
    exist_ok=True
)


OUTPUT_SUMMARY_CSV = os.path.join(
    OUTPUT_DIR,
    "profit_distribution_analysis.csv"
)

OUTPUT_CONTRIBUTION_CSV = os.path.join(
    OUTPUT_DIR,
    "profit_contribution_analysis.csv"
)

OUTPUT_STRESS_CSV = os.path.join(
    OUTPUT_DIR,
    "profit_stress_test.csv"
)

OUTPUT_BOXPLOT = os.path.join(
    OUTPUT_DIR,
    "profit_distribution_boxplot.png"
)

OUTPUT_BOXPLOT_TRIMMED = os.path.join(
    OUTPUT_DIR,
    "profit_distribution_boxplot_trimmed.png"
)

OUTPUT_CONTRIBUTION_GRAPH = os.path.join(
    OUTPUT_DIR,
    "top_profit_contribution.png"
)

OUTPUT_STRESS_GRAPH = os.path.join(
    OUTPUT_DIR,
    "profit_factor_stress_test.png"
)


# ============================================================
# データ読み込み
# ============================================================

df = pd.read_csv(
    INPUT_FILE
)


print(
    "========================================"
)

print(
    "PROFIT DISTRIBUTION ANALYSIS"
)

print(
    "========================================"
)

print(
    f"\n読み込み件数: {len(df)}"
)


# ============================================================
# 必要列確認
# ============================================================

required_columns = [
    "entry_band_distance_pips",
    "entry_atr14_pips",
    "profit"
]


missing_columns = [
    column
    for column in required_columns
    if column not in df.columns
]


if missing_columns:

    raise ValueError(
        "必要な列がありません: "
        + ", ".join(missing_columns)
    )


# ============================================================
# 数値型へ変換
# ============================================================

for column in required_columns:

    df[column] = pd.to_numeric(
        df[column],
        errors="coerce"
    )


# ============================================================
# 分析対象
# ============================================================

analysis_df = df[
    df["entry_band_distance_pips"].notna()
    &
    df["entry_atr14_pips"].notna()
    &
    df["profit"].notna()
    &
    (
        df["entry_atr14_pips"]
        > 0
    )
].copy()


if analysis_df.empty:

    raise ValueError(
        "分析対象データがありません。"
    )


print(
    f"分析対象件数: {len(analysis_df)}"
)


# ============================================================
# Relative Band Distance
# ============================================================

analysis_df[
    "relative_band_distance"
] = (
    analysis_df[
        "entry_band_distance_pips"
    ]
    /
    analysis_df[
        "entry_atr14_pips"
    ]
)


analysis_df[
    "relative_band_distance"
] = (
    analysis_df[
        "relative_band_distance"
    ]
    .replace(
        [
            np.inf,
            -np.inf
        ],
        np.nan
    )
)


analysis_df = analysis_df[
    analysis_df[
        "relative_band_distance"
    ]
    .notna()
].copy()


# ============================================================
# Relative Band Distanceを四分位化
# ============================================================

quartile_order = [
    "Q1",
    "Q2",
    "Q3",
    "Q4"
]


analysis_df[
    "relative_band_group"
] = pd.qcut(
    analysis_df[
        "relative_band_distance"
    ],
    q=4,
    labels=quartile_order
)


# ============================================================
# PF計算関数
# ============================================================

def calculate_pf(data):

    gross_profit = (
        data.loc[
            data["profit"] > 0,
            "profit"
        ]
        .sum()
    )

    gross_loss = abs(
        data.loc[
            data["profit"] < 0,
            "profit"
        ]
        .sum()
    )

    if gross_loss == 0:

        return np.nan

    return (
        gross_profit
        /
        gross_loss
    )


# ============================================================
# 分布統計
# ============================================================

summary_rows = []


for group_name in quartile_order:

    group_df = analysis_df[
        analysis_df[
            "relative_band_group"
        ]
        == group_name
    ].copy()


    profit = group_df[
        "profit"
    ]


    summary_rows.append(
        {
            "group": group_name,

            "trades": len(
                group_df
            ),

            "wins": (
                profit > 0
            ).sum(),

            "losses": (
                profit < 0
            ).sum(),

            "win_rate": (
                (
                    profit > 0
                ).mean()
                * 100
            ),

            "total_profit": (
                profit.sum()
            ),

            "average_profit": (
                profit.mean()
            ),

            "minimum_profit": (
                profit.min()
            ),

            "q25_profit": (
                profit.quantile(
                    0.25
                )
            ),

            "median_profit": (
                profit.median()
            ),

            "q75_profit": (
                profit.quantile(
                    0.75
                )
            ),

            "q90_profit": (
                profit.quantile(
                    0.90
                )
            ),

            "q95_profit": (
                profit.quantile(
                    0.95
                )
            ),

            "maximum_profit": (
                profit.max()
            ),

            "profit_factor": (
                calculate_pf(
                    group_df
                )
            )
        }
    )


summary_df = pd.DataFrame(
    summary_rows
)


summary_df = (
    summary_df
    .set_index(
        "group"
    )
)


# ============================================================
# 小数点整理
# ============================================================

summary_df[
    "win_rate"
] = (
    summary_df[
        "win_rate"
    ]
    .round(2)
)


round_columns = [
    "total_profit",
    "average_profit",
    "minimum_profit",
    "q25_profit",
    "median_profit",
    "q75_profit",
    "q90_profit",
    "q95_profit",
    "maximum_profit"
]


for column in round_columns:

    summary_df[
        column
    ] = (
        summary_df[
            column
        ]
        .round(2)
    )


summary_df[
    "profit_factor"
] = (
    summary_df[
        "profit_factor"
    ]
    .round(3)
)


print(
    "\n========================================"
)

print(
    "損益分布"
)

print(
    "========================================"
)


print(
    summary_df
)


summary_df.to_csv(
    OUTPUT_SUMMARY_CSV,
    encoding="utf-8-sig"
)


# ============================================================
# 上位利益寄与率
# ============================================================

contribution_rows = []


for group_name in quartile_order:

    group_df = analysis_df[
        analysis_df[
            "relative_band_group"
        ]
        == group_name
    ].copy()


    winning_df = group_df[
        group_df[
            "profit"
        ]
        > 0
    ].copy()


    winning_df = winning_df.sort_values(
        by="profit",
        ascending=False
    )


    gross_profit = (
        winning_df[
            "profit"
        ]
        .sum()
    )


    win_count = len(
        winning_df
    )


    top_10_count = max(
        1,
        math.ceil(
            win_count
            * 0.10
        )
    )


    top_5_count = max(
        1,
        math.ceil(
            win_count
            * 0.05
        )
    )


    top_10_profit = (
        winning_df
        .head(
            top_10_count
        )
        [
            "profit"
        ]
        .sum()
    )


    top_5_profit = (
        winning_df
        .head(
            top_5_count
        )
        [
            "profit"
        ]
        .sum()
    )


    if gross_profit > 0:

        top_10_share = (
            top_10_profit
            /
            gross_profit
            * 100
        )

        top_5_share = (
            top_5_profit
            /
            gross_profit
            * 100
        )

    else:

        top_10_share = np.nan
        top_5_share = np.nan


    contribution_rows.append(
        {
            "group": group_name,

            "winning_trades": win_count,

            "gross_profit": gross_profit,

            "top_10_count": top_10_count,

            "top_10_profit": top_10_profit,

            "top_10_profit_share": top_10_share,

            "top_5_count": top_5_count,

            "top_5_profit": top_5_profit,

            "top_5_profit_share": top_5_share
        }
    )


contribution_df = pd.DataFrame(
    contribution_rows
)


contribution_df = (
    contribution_df
    .set_index(
        "group"
    )
)


for column in [
    "gross_profit",
    "top_10_profit",
    "top_5_profit"
]:

    contribution_df[
        column
    ] = (
        contribution_df[
            column
        ]
        .round(2)
    )


for column in [
    "top_10_profit_share",
    "top_5_profit_share"
]:

    contribution_df[
        column
    ] = (
        contribution_df[
            column
        ]
        .round(2)
    )


print(
    "\n========================================"
)

print(
    "上位利益取引の寄与率"
)

print(
    "========================================"
)


print(
    contribution_df
)


contribution_df.to_csv(
    OUTPUT_CONTRIBUTION_CSV,
    encoding="utf-8-sig"
)


# ============================================================
# 上位勝ち取引除外ストレステスト
# ============================================================

stress_rows = []


for group_name in quartile_order:

    group_df = analysis_df[
        analysis_df[
            "relative_band_group"
        ]
        == group_name
    ].copy()


    original_pf = (
        calculate_pf(
            group_df
        )
    )


    winning_df = group_df[
        group_df[
            "profit"
        ]
        > 0
    ].sort_values(
        by="profit",
        ascending=False
    )


    win_count = len(
        winning_df
    )


    top_10_count = max(
        1,
        math.ceil(
            win_count
            * 0.10
        )
    )


    top_5_count = max(
        1,
        math.ceil(
            win_count
            * 0.05
        )
    )


    top_10_indices = (
        winning_df
        .head(
            top_10_count
        )
        .index
    )


    top_5_indices = (
        winning_df
        .head(
            top_5_count
        )
        .index
    )


    without_top_10 = (
        group_df
        .drop(
            index=top_10_indices
        )
    )


    without_top_5 = (
        group_df
        .drop(
            index=top_5_indices
        )
    )


    pf_without_top_10 = (
        calculate_pf(
            without_top_10
        )
    )


    pf_without_top_5 = (
        calculate_pf(
            without_top_5
        )
    )


    total_profit_without_top_10 = (
        without_top_10[
            "profit"
        ]
        .sum()
    )


    total_profit_without_top_5 = (
        without_top_5[
            "profit"
        ]
        .sum()
    )


    stress_rows.append(
        {
            "group": group_name,

            "original_pf": (
                original_pf
            ),

            "pf_without_top_5_percent_winners": (
                pf_without_top_5
            ),

            "pf_without_top_10_percent_winners": (
                pf_without_top_10
            ),

            "total_profit_without_top_5_percent_winners": (
                total_profit_without_top_5
            ),

            "total_profit_without_top_10_percent_winners": (
                total_profit_without_top_10
            )
        }
    )


stress_df = pd.DataFrame(
    stress_rows
)


stress_df = (
    stress_df
    .set_index(
        "group"
    )
)


for column in [
    "original_pf",
    "pf_without_top_5_percent_winners",
    "pf_without_top_10_percent_winners"
]:

    stress_df[
        column
    ] = (
        stress_df[
            column
        ]
        .round(3)
    )


for column in [
    "total_profit_without_top_5_percent_winners",
    "total_profit_without_top_10_percent_winners"
]:

    stress_df[
        column
    ] = (
        stress_df[
            column
        ]
        .round(2)
    )


print(
    "\n========================================"
)

print(
    "大勝ち除外ストレステスト"
)

print(
    "========================================"
)


print(
    stress_df
)


stress_df.to_csv(
    OUTPUT_STRESS_CSV,
    encoding="utf-8-sig"
)


# ============================================================
# 箱ひげ図
# ============================================================

boxplot_data = [
    analysis_df.loc[
        analysis_df[
            "relative_band_group"
        ]
        == group,
        "profit"
    ]
    for group in quartile_order
]


fig, ax = plt.subplots(
    figsize=(9, 6)
)


ax.boxplot(
    boxplot_data,
    tick_labels=quartile_order
)


ax.axhline(
    y=0,
    linestyle="--"
)


ax.set_xlabel(
    "Relative Band Distance Quartile"
)


ax.set_ylabel(
    "Profit"
)


ax.set_title(
    "Profit Distribution by Relative Band Distance"
)


ax.grid(
    axis="y",
    alpha=0.3
)


plt.tight_layout()


plt.savefig(
    OUTPUT_BOXPLOT,
    dpi=150
)


plt.close()


# ============================================================
# 上下1%を除いた箱ひげ図
# ============================================================

lower_limit = (
    analysis_df[
        "profit"
    ]
    .quantile(
        0.01
    )
)


upper_limit = (
    analysis_df[
        "profit"
    ]
    .quantile(
        0.99
    )
)


trimmed_df = analysis_df[
    (
        analysis_df[
            "profit"
        ]
        >= lower_limit
    )
    &
    (
        analysis_df[
            "profit"
        ]
        <= upper_limit
    )
].copy()


trimmed_boxplot_data = [
    trimmed_df.loc[
        trimmed_df[
            "relative_band_group"
        ]
        == group,
        "profit"
    ]
    for group in quartile_order
]


fig, ax = plt.subplots(
    figsize=(9, 6)
)


ax.boxplot(
    trimmed_boxplot_data,
    tick_labels=quartile_order
)


ax.axhline(
    y=0,
    linestyle="--"
)


ax.set_xlabel(
    "Relative Band Distance Quartile"
)


ax.set_ylabel(
    "Profit"
)


ax.set_title(
    "Profit Distribution by Relative Band Distance (1%-99%)"
)


ax.grid(
    axis="y",
    alpha=0.3
)


plt.tight_layout()


plt.savefig(
    OUTPUT_BOXPLOT_TRIMMED,
    dpi=150
)


plt.close()


# ============================================================
# 上位利益寄与率グラフ
# ============================================================

contribution_plot_df = (
    contribution_df[
        [
            "top_5_profit_share",
            "top_10_profit_share"
        ]
    ]
)


fig, ax = plt.subplots(
    figsize=(9, 6)
)


contribution_plot_df.plot(
    kind="bar",
    ax=ax
)


ax.set_xlabel(
    "Relative Band Distance Quartile"
)


ax.set_ylabel(
    "Share of Gross Profit (%)"
)


ax.set_title(
    "Contribution of Top Winning Trades"
)


ax.tick_params(
    axis="x",
    rotation=0
)


ax.grid(
    axis="y",
    alpha=0.3
)


plt.tight_layout()


plt.savefig(
    OUTPUT_CONTRIBUTION_GRAPH,
    dpi=150
)


plt.close()


# ============================================================
# PFストレステストグラフ
# ============================================================

stress_plot_df = (
    stress_df[
        [
            "original_pf",
            "pf_without_top_5_percent_winners",
            "pf_without_top_10_percent_winners"
        ]
    ]
)


fig, ax = plt.subplots(
    figsize=(9, 6)
)


stress_plot_df.plot(
    kind="bar",
    ax=ax
)


ax.axhline(
    y=1.0,
    linestyle="--"
)


ax.set_xlabel(
    "Relative Band Distance Quartile"
)


ax.set_ylabel(
    "Profit Factor"
)


ax.set_title(
    "Profit Factor Stress Test"
)


ax.tick_params(
    axis="x",
    rotation=0
)


ax.grid(
    axis="y",
    alpha=0.3
)


plt.tight_layout()


plt.savefig(
    OUTPUT_STRESS_GRAPH,
    dpi=150
)


plt.close()


# ============================================================
# 全体結果
# ============================================================

print(
    "\n========================================"
)

print(
    "分析完了"
)

print(
    "========================================"
)


print(
    "\n出力ファイル:"
)


print(
    OUTPUT_SUMMARY_CSV
)


print(
    OUTPUT_CONTRIBUTION_CSV
)


print(
    OUTPUT_STRESS_CSV
)


print(
    OUTPUT_BOXPLOT
)


print(
    OUTPUT_BOXPLOT_TRIMMED
)


print(
    OUTPUT_CONTRIBUTION_GRAPH
)


print(
    OUTPUT_STRESS_GRAPH
)
コメント